Payload CMS et Next.js : construire un socle de sites vitrines
Comment Payload CMS s’intègre à Next.js, comment construire un page builder typé de bout en bout, et comment faire vivre un socle partagé entre plusieurs sites vitrines : ce qui reste commun, ce qui varie, et comment les corrections du socle arrivent dans chaque dépôt client. Les exemples viennent d’un socle que j’ai développé et éprouvé sur un site de démonstration.
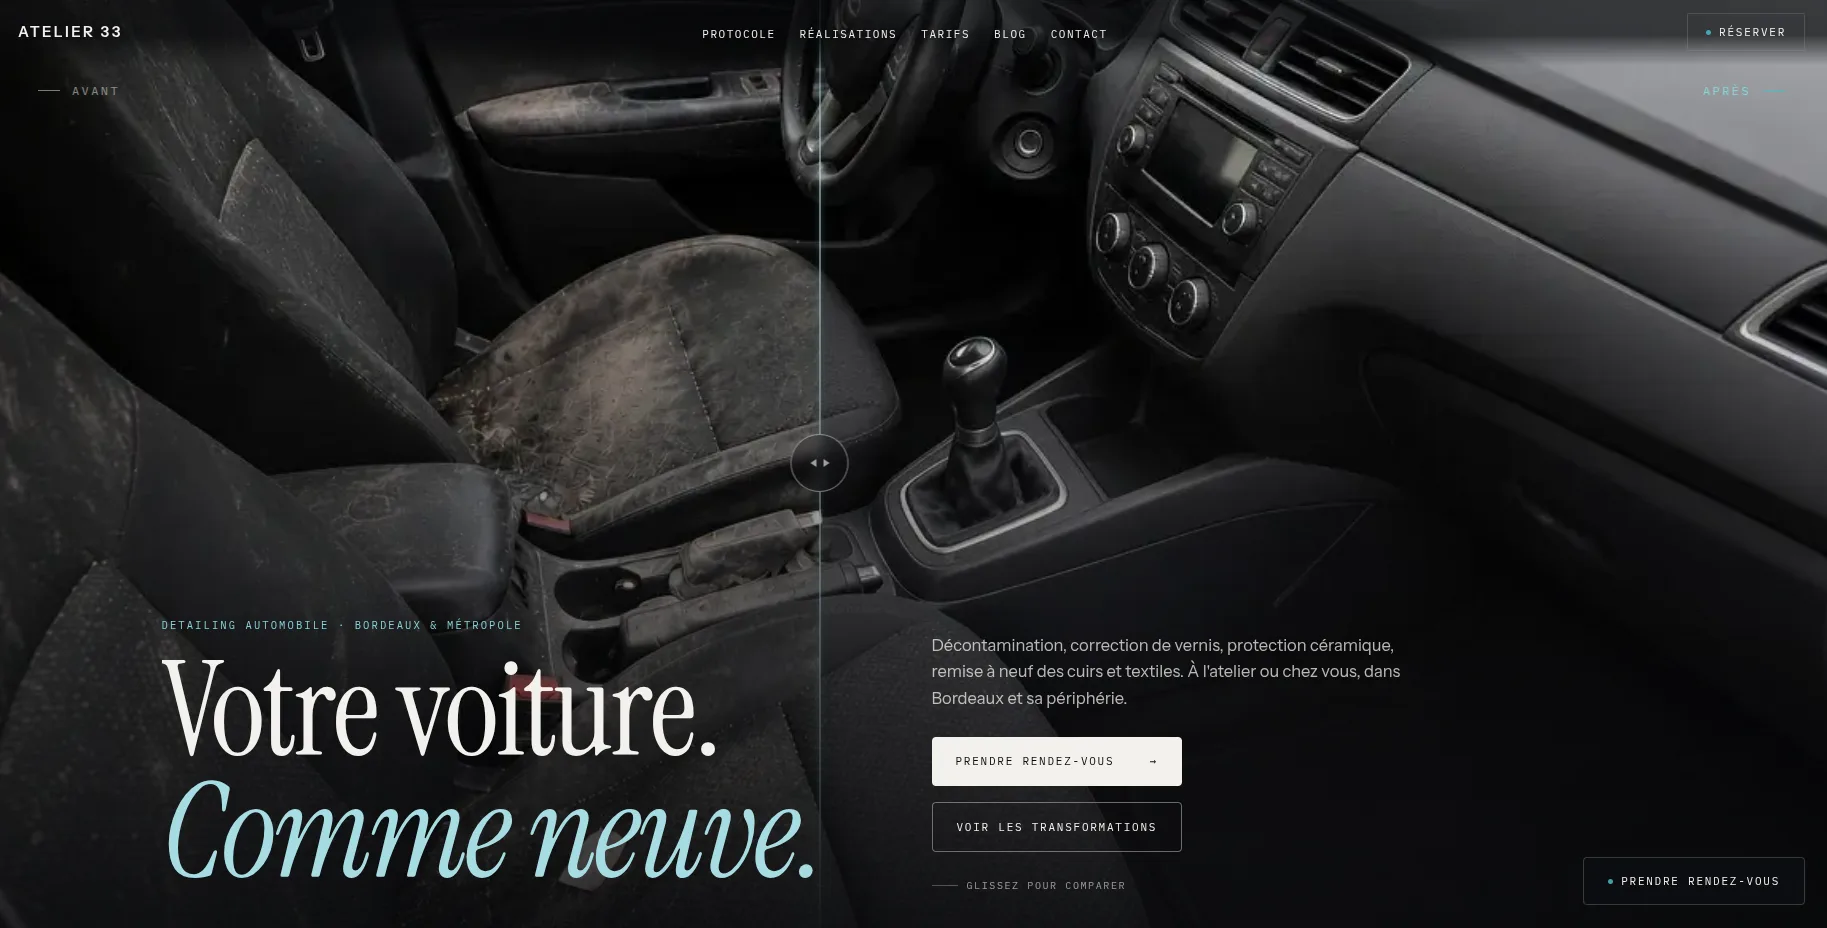
Un site vitrine ressemble beaucoup au précédent. Il lui faut des pages éditables, un blog, un formulaire de contact, des pages légales, un bandeau de cookies et un SEO soigné avant même d’arriver à ce qui le distingue. Après avoir refait ces briques sur plusieurs projets, j’ai développé un socle réutilisable avec Payload CMS et Next.js, puis je l’ai éprouvé sur Atelier 33, un site de démonstration réalisé en une semaine en faisant évoluer le socle au passage. Cet article reprend les choix qui se transposent à d’autres projets : l’intégration de Payload à Next.js, la construction d’un page builder typé, et l’organisation d’un socle partagé entre plusieurs sites.
Pourquoi Payload CMS avec Next.js ?
Payload est un CMS headless open source écrit en TypeScript, dont la configuration se fait dans le code. Les collections, les champs, les blocs et les droits d’accès sont des fichiers du dépôt, versionnés et relus en code review comme le reste de l’application. La commande payload generate:types en tire les types utilisés par le front-end. Une fois les types régénérés, un champ renommé dans le schéma fait échouer la compilation des composants qui l’utilisent au lieu de casser une page en production.
Depuis sa version 3, Payload s’installe dans l’application Next.js elle-même. L’interface d’administration, l’API et le site public forment un seul projet, et un Server Component lit ses données par la Local API, qui interroge directement la base sans aller-retour HTTP :
// Simplified example: a Server Component reads a page through the Local API
import { getPayload } from 'payload'
import config from '@payload-config'

const payload = await getPayload({ config })
const { docs } = await payload.find({
  collection: 'pages',
  where: { slug: { equals: slug } },
  limit: 1,
})
Il n’y a donc qu’une application à développer, à tester et à déployer. L’auto-hébergement a un coût, puisque les mises à jour du serveur, de PostgreSQL et de Payload me reviennent. En échange, il n’y a pas d’abonnement CMS par client et je choisis où les données sont hébergées. Les plugins officiels couvrent une bonne partie des besoins d’un site vitrine (SEO, redirections, formulaires, recherche). Pour une équipe qui ne veut pas gérer d’infrastructure, un CMS en SaaS comme Prismic reste un meilleur choix.
Comment construire un page builder avec Payload ?
Le page builder permet au client de composer ses pages dans l’administration en empilant des blocs (hero, texte et image, galerie, FAQ, tarifs, prise de rendez-vous…), sans repasser par un développeur. Dans Payload, un bloc est un schéma de champs :
// blocks/Stats/config.ts (simplified)
import type { Block } from 'payload'

export const Stats: Block = {
  slug: 'stats',
  interfaceName: 'StatsBlock', // name of the generated TypeScript type
  fields: [
    { name: 'heading', type: 'text' },
    {
      name: 'stats',
      type: 'array',
      minRows: 1,
      required: true,
      fields: [
        { name: 'value', type: 'text', required: true },
        { name: 'label', type: 'text', required: true },
      ],
    },
  ],
}
La collection des pages déclare un champ blocks qui liste les blocs autorisés, et le front-end associe chaque bloc à un composant. Comme le type de chaque bloc vient des types générés, chaque composant reçoit exactement les champs saisis dans l’administration :
// components/PageBlocks.tsx (simplified)
import type { HeroBlock, StatsBlock } from '@/payload-types'

type RenderableBlock = HeroBlock | StatsBlock

export function PageBlocks({ layout }: { layout: RenderableBlock[] }) {
  return layout.map((block, index) => {
    switch (block.blockType) {
      case 'hero':
        return <HeroBlockComponent key={block.id ?? index} {...block} />
      case 'stats':
        return <StatsBlockComponent key={block.id ?? index} {...block} />
      default:
        return null
    }
  })
}
Une validation complète le schéma. Une page ne doit porter qu’un seul titre h1, pour le SEO comme pour l’accessibilité, or rien n’empêche un client d’ajouter un hero dans une page qui en contient déjà un. Le champ blocks reçoit donc une validation personnalisée. Dans Payload, une fonction validate remplace la validation par défaut du champ au lieu de s’y ajouter ; sans précaution, required ou minRows cessent d’être vérifiés. La validation d’origine, exportée par payload/shared, est donc appelée en premier :
// Simplified example
import type { BlocksFieldValidation } from 'payload'
import { blocks } from 'payload/shared'

// rendersH1(block): true for the blocks that render their own <h1>, such as the hero
export function limitH1Blocks(max: number, message: string): BlocksFieldValidation {
  return async (value, options) => {
    // A custom validate replaces the default one: run the native checks first
    const native = await blocks(value, options)
    if (native !== true) return native

    const h1Count = (Array.isArray(value) ? value : []).filter(rendersH1).length
    return h1Count > max ? message : true
  }
}
Un dépôt par client ou une plateforme multi-tenant ?
Une seule application pour tous les clients aurait demandé d’isoler les données par tenant, de conditionner les droits d’accès au tenant courant et de partager l’administration. Le multi-tenant se justifie surtout quand les tenants partagent des données. Sur la DXP Goodbizz, par exemple, les canaux d’un même client peuvent exploiter le même catalogue et la même médiathèque. Des sites vitrines de clients différents ne partagent rien : chaque client a donc son dépôt et son déploiement, sans champ tenant ni plugin multi-tenant à maintenir.
Chaque site tourne dans Docker sur un VPS, avec une image construite par la CI, PostgreSQL, et Caddy en reverse proxy pour le certificat TLS. Le coût d’hébergement reste prévisible, et les sauvegardes font partie du socle, avec une restauration de test avant chaque mise en ligne. Le détail fait l’objet d’un article sur le déploiement.
Qu’est-ce qui est partagé, qu’est-ce qui diverge ?
La frontière la plus utile passe à l’intérieur même des blocs. Le schéma d’un bloc, c’est-à-dire ses champs dans l’administration, est identique sur tous les sites : un même bloc se saisit partout de la même façon, et une évolution de ce schéma peut être reportée sur chaque site. Le rendu (composant, styles, design system) est en revanche le point de départ que j’adapte à l’identité de chaque client.
J’ai envisagé de rendre cette frontière visible dans l’arborescence, avec un dossier core/ pour le socle et un dossier custom/ pour le client, afin de limiter les conflits lors des mises à jour. Je ne l’ai pas retenu. Il fallait déplacer environ 150 fichiers et ajouter des registres pour brancher les blocs, alors que le gain restait théorique tant qu’aucun dépôt client ne subissait réellement ces conflits. La décision est notée dans la documentation du socle, avec la condition qui la ferait revoir.
Ce qui varie d’un client à l’autre passe autant que possible par la configuration. Une fonctionnalité comme la prise de rendez-vous s’active depuis l’administration, au lieu d’exister en deux versions dans deux dépôts.
Comment reporter les évolutions du socle sur chaque site ?
Sans packages versionnés, une correction du socle se reporte avec git, ce qui suppose que le dépôt client partage l’historique du socle. Le bouton « Use this template » de GitHub crée un dépôt qui démarre sur un seul commit, sans lien avec l’historique du modèle. Un merge ultérieur exige alors l’option --allow-unrelated-histories, et chaque fichier qui diffère entre les deux dépôts devient un conflit. Créer le dépôt client par un clone évite ce piège :
# Create the client repository from a clone, so it shares the base's history
git clone git@github.com:me/site-base.git client-acme
cd client-acme
git remote rename origin upstream
git remote add origin git@github.com:me/client-acme.git
git push -u origin main

# Later: bring in the base's fixes and improvements
git fetch upstream
git merge upstream/main
Pour une correction isolée, un git cherry-pick suffit. Dans les deux cas, les merges restent simples tant que le dépôt client reste proche du socle, d’où la règle de ne pas renommer ni réorganiser ce qui n’a pas besoin de changer.
Le chemin inverse compte autant. Ce qu’un projet client révèle de générique remonte dans le socle : la prise de rendez-vous, développée pour Atelier 33, en fait désormais partie. En fin de projet, une courte note dans le dépôt client recense ce qui mérite de remonter et les raccourcis pris sous la pression du délai, avant de démarrer le site suivant.
Que doit contenir un socle de site vitrine ?
La liste dépend des clients visés. Pour des sites vitrines, ces briques reviennent presque à chaque projet, et certaines demandent plus de réflexion qu’il n’y paraît :
- un blog, des formulaires gérés depuis l’administration, et des redirections pour les anciennes URL, indispensables quand le site en remplace un autre ;
- des rôles admin et éditeur, pour séparer la configuration du site de la saisie du contenu ;
- un SEO réglable page par page, avec un aperçu avant publication ;
- un script de purge des données personnelles selon des durées de conservation configurables. Il refuse une durée vide ou invalide, car une variable mal renseignée, lue comme zéro jour, supprimerait tout ;
- des pages légales créées avec un squelette et un avertissement explicite. Un brouillon peut être généré à partir de la configuration (cookies, durées de conservation, prise de rendez-vous), mais l’identité de l’entreprise reste à renseigner, pour qu’aucun texte juridique inventé ou générique ne soit publié par erreur ;
- le consentement aux cookies, dont la mise en œuvre est détaillée dans l’article sur le consentement RGPD avec Next.js.
Comment tester un socle dont dépendent plusieurs sites ?
Une régression du socle se retrouve dans chaque site au merge suivant, ce qui donne aux tests plus de poids que dans un projet isolé. Le socle suit une démarche TDD sur la logique (créneaux de réservation, listes du blog), avec des tests unitaires et d’intégration, et des parcours Playwright, dont un audit d’accessibilité automatique avec axe-core.
Deux contrôles dépassent le code de l’application. La CI lance les tests de bout en bout sur le build de production, puis démarre le fichier Docker Compose de production sur les images qu’elle vient de construire, pour vérifier qu’elles fonctionnent réellement. Un second script rejoue la restauration d’une sauvegarde, pour éprouver la procédure avant d’en avoir besoin.
Quelles sont les limites ?
- Un socle impose ses choix : un site très atypique, dont la structure sort du cadre des blocs, gagne peu à en partir.
- Les évolutions se reportent à la main, dépôt par dépôt. C’est raisonnable avec quelques clients ; au-delà, des packages versionnés partagés deviendraient plus adaptés.
- L’auto-hébergement demande un suivi régulier, entre mises à jour du serveur, des dépendances et de Payload, et surveillance des sauvegardes.
- Le socle n’est pas encore déployé chez un client en production. Atelier 33 sert de banc d’essai, et certains choix restent à confronter aux retours d’un client qui édite lui-même son site.