Développer une DXP multi-tenants
Retour d’expérience sur Goodbizz, une DXP multi-tenants développée chez Ikomobi : architecture en microservices, données séparées par tenant, permissions définies action par action sur chaque partie d’un module, bibliothèque de médias et consentement RGPD.
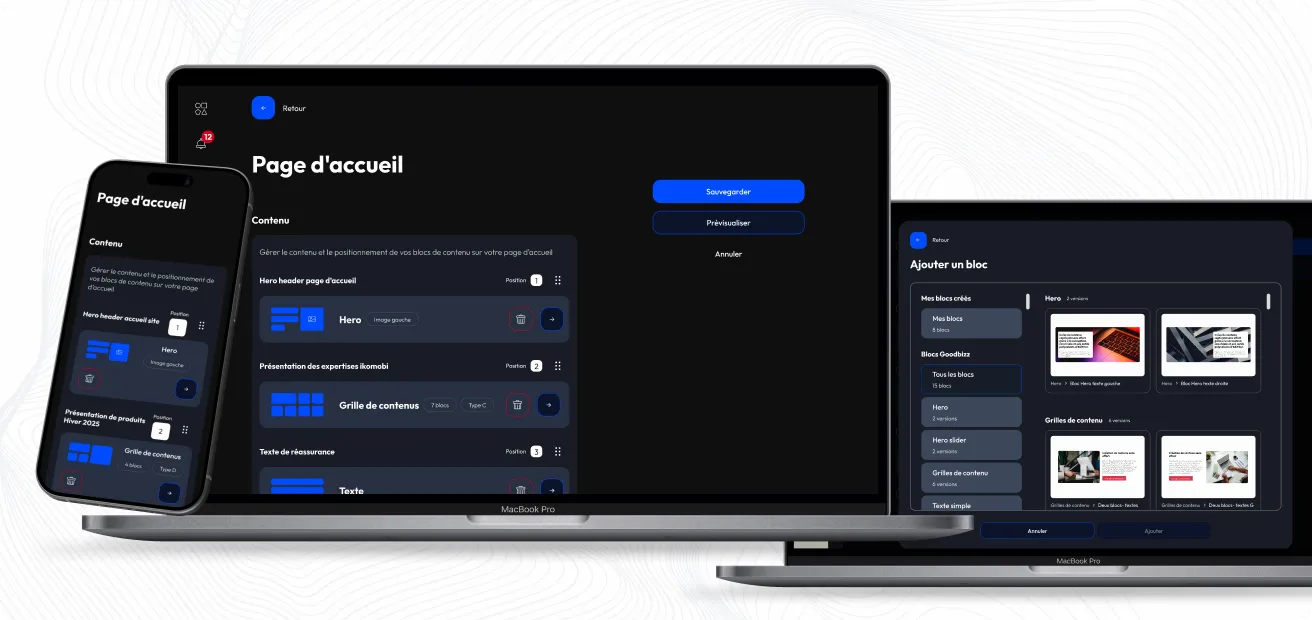
Un CMS gère des pages ; une DXP (Digital Experience Platform) structure des contenus et des ressources pour les diffuser sur plusieurs canaux et à plusieurs équipes. Chez Ikomobi, nous avons développé en interne Goodbizz, une DXP multi-tenants. Le projet reposait sur une première base écrite par d’anciens collègues, mise en pause tant que les projets clients passaient en priorité, et c’est à partir d’elle que nous avons relancé le projet (reprendre une base de code existante revient sur cette situation). L’équipe comptait un lead dev, deux développeurs fullstack et un intégrateur, épaulés par un chef de projet et un designer. Chacun avait ses modules, sans s’interdire d’intervenir sur le reste. J’ai principalement travaillé sur le multi-tenant, l’authentification, les rôles, la gestion des utilisateurs, la bibliothèque de médias, le consentement RGPD et le module trade, ainsi que sur une partie du front Next.js.
À quoi sert cette DXP ?
Chaque client dispose de sa propre instance de Goodbizz, qui répond à trois usages :
- alimenter des sites web, construits à partir de templates et de blocs gérés dans le back-office ;
- alimenter des e-mails, qu’ils soient automatiques, marketing ou de notification ;
- servir de gestionnaire de ressources aux équipes métier, avec une bibliothèque de fichiers partagée.
Dans une instance, chaque canal du client est un tenant : un site web, une application mobile ou un blog, avec son domaine, ses langues et les modules qui lui sont activés. Un client qui gère plusieurs sites a donc autant de tenants.
Servir plusieurs canaux pèse sur toute la conception. Les données doivent être pensées indépendamment de leur rendu, et ce qui appartient à un tenant doit rester séparé des autres, alors que certaines données, comme le catalogue ou la bibliothèque, peuvent être partagées entre eux.
Comment découper la plateforme en microservices ?
La plateforme se répartit entre plusieurs services Node.js / Express, chacun responsable d’un domaine :
- une API gateway, point d’entrée du back-office React et des fronts ;
- un service d’authentification, qui gère utilisateurs, rôles, tenants et sessions ;
- un service de contenus, qui couvre les pages, les templates et les blocs, les menus, la FAQ, le blog, les formulaires, les URL, les langues et les aperçus ;
- un service de bibliothèque de fichiers ;
- un catalogue produits, socle du moteur e-commerce.
L’API gateway relaie les requêtes aux services en HTTP, et les services s’authentifient entre eux grâce à un token de service. MySQL accueille les données relationnelles, MongoDB les structures plus souples, comme les templates et les blocs du page builder, les rôles ou la bibliothèque. Quant aux sites publics, ils sont rendus côté serveur avec Next.js.
En m’appuyant sur le catalogue produits, j’ai développé le module trade, qui gère les boutiques, les paniers, les commandes et le suivi de leurs étapes, les e-mails de commande et les avis clients. Avec l’accord du lead dev et du CTO, j’ai aussi fait passer la plupart des services à Express 5 et Mongoose 8.
Côté sites publics, j’ai aussi intégré dans le front Next.js le blog, la partie trade, avec la liste et les fiches produits, des galeries d’images et de documents tirés de la bibliothèque et le gestionnaire de consentement, et participé à l’intégration des blocs du page builder. Ce front nous a servi à tester la plateforme sur un cas concret, un site de vente de matériaux pour un grand compte.
Comment isoler les données de chaque tenant ?
J’ai développé la partie multi-tenant. Au lieu d’une base de données par tenant, la plateforme utilise une base partagée, où les données propres à un tenant portent son identifiant. Ce choix répond d’abord à l’usage, car les tenants d’un même client peuvent mettre en commun le catalogue produits, la bibliothèque ou les utilisateurs, ce que des bases séparées obligeraient à dupliquer ou à synchroniser. Il offre aussi une seule base à faire évoluer et à déployer, avec une contrepartie importante : chaque accès aux données doit conserver le contexte du tenant.
Le tenant est inscrit dans le token d’authentification de l’utilisateur. L’API gateway le transmet à chaque service, qui l’utilise pour filtrer ses lectures comme ses écritures. Les rôles eux-mêmes appartiennent à un tenant, si bien qu’un rôle du même nom peut accorder des droits différents sur le site et sur le blog. De la même façon, un produit commun du catalogue a sa propre URL sur chaque tenant.
Le risque d’une base partagée tient en une ligne oubliée. Une seule requête écrite sans le filtre du tenant suffit à exposer les données d’un client à un autre. La protection la plus sûre consiste à ne pas confier ce filtre à chaque requête, mais à une couche qui l’ajoute d’office et refuse toute requête sans tenant. Avec Node.js et Mongoose, le tenant de la requête en cours peut être conservé avec AsyncLocalStorage, puis appliqué par un middleware de requête :
// Simplified example: the current request's tenant, available in any function
const { AsyncLocalStorage } = require('node:async_hooks')
const tenantContext = new AsyncLocalStorage()

// Express middleware, after authentication
app.use((req, res, next) => tenantContext.run({ tenantId: req.auth.tenantId }, next))

// Mongoose plugin for tenant-owned collections: no query runs without the tenant filter
function tenantScoped(schema) {
  const operations = ['find', 'findOne', 'countDocuments', 'findOneAndUpdate', 'updateOne', 'updateMany', 'deleteOne', 'deleteMany']
  schema.pre(operations, async function () {
    const tenantId = tenantContext.getStore()?.tenantId
    if (!tenantId) throw new Error('Query without tenant context')
    this.where({ tenantId })
  })
}
Les écritures doivent recevoir le même identifiant, et un test d’intégration complète le dispositif en vérifiant qu’un utilisateur d’un tenant ne lit jamais les données d’un autre.
Comment définir des permissions à la tâche près ?
La gestion des rôles, que j’ai reprise, devait offrir une granularité fine. Chaque module de la plateforme (EdiThor, catalogue PIM, trade…) est découpé en parties, une par type de ressource. Le catalogue distingue ainsi produits, collections, fournisseurs, promotions, livraisons et taxes. Un rôle énumère ces parties et, pour chacune, les actions autorisées (lire, créer, modifier, supprimer et, selon le module, publier ou télécharger). Chaque tenant peut ajuster ses rôles, voire en créer de nouveaux. En voici la structure, simplifiée pour l’article :
// Simplified example
// A role belongs to one tenant and grants rights on each part of a module
const editorRole = {
  tenantId: 'tenant-a',
  name: 'Éditeur',
  modules: [
    {identifier: 'edithor-page', rights: {read: true, create: true, update: true, remove: false, publish: false}},
    {identifier: 'pim-supplier-management', rights: {read: true, create: false, update: false, remove: false}},
    {identifier: 'library', rights: {read: true, create: true, update: true, remove: true, download: true}},
  ],
};

// The API maps each HTTP method to the right it requires
const requiredRight = {POST: 'create', PUT: 'update', PATCH: 'update', DELETE: 'remove'};
Côté API, un middleware associe chaque requête d’écriture au droit qu’elle exige sur la partie visée, et la rejette si le rôle ne l’accorde pas. La plateforme collaborative SRS applique le même principe avec des rôles plus simples.
Comment sécuriser l’authentification ?
J’ai également repris le module d’authentification, qui distingue les administrateurs du back-office des utilisateurs des fronts, ainsi que la gestion de ces deux populations. Le tenant de chaque compte figure dans son token. Les mots de passe sont hachés, leur réinitialisation passe par e-mail, et l’option « rester connecté » s’appuie sur des sessions dont seule une empreinte du token est conservée.
La connexion utilise une double authentification, et les tentatives échouées sont comptées. Passé un certain nombre, l’accès est temporairement bloqué, ce qui freine les attaques par force brute. Le traitement de chaque secret est détaillé dans un article dédié.
C’est aussi sur ce microservice que j’ai d’abord utilisé Claude Code en production, avant de commencer à l’étendre au back-office.
Que contient la bibliothèque de médias ?
Cœur du gestionnaire de ressources, la bibliothèque de fichiers fait aussi partie des modules que j’ai repris. Chaque type de média y reçoit un traitement adapté dès l’import :
- les images sont redimensionnées et optimisées, et leurs métadonnées lues ;
- les vidéos et les fichiers audio sont analysés, et le texte des PDF est extrait ;
- les doublons sont repérés grâce à une empreinte calculée à l’import, visuelle pour les images et SHA-256 pour les autres fichiers, puis comparée en base ;
- les fichiers se téléchargent en lot dans une archive zip, et l’espace disque occupé est suivi.
J’ai aussi repris les statistiques et les outils de suivi de la bibliothèque. Ils retracent l’utilisation des fichiers et des dossiers ainsi que l’historique des actions, et signalent les médias trop volumineux, les doublons, les fichiers mal nommés ou devenus inutiles. Les équipes ont ainsi de quoi garder une bibliothèque propre et cohérente dans la durée.
Comment gérer le consentement et le RGPD ?
Une plateforme qui envoie des e-mails marketing doit pouvoir prouver le consentement donné par chaque utilisateur (article 7 du RGPD). Un module dédié, que j’ai repris, conserve donc les consentements et leurs preuves, ainsi que les politiques de confidentialité qui s’y rapportent. Côté sites publics, le gestionnaire de consentement que j’ai intégré recueille les choix de chaque visiteur.
Quels choix aurait-il fallu fixer plus tôt ?
Je poserais plus tôt, avec l’équipe, les choix techniques structurants et le périmètre de chaque service, avant d’entrer dans l’implémentation. Le rattachement des données aux tenants en est le meilleur exemple.
Les noms de rôles étaient d’abord uniques sur toute la plateforme. Pour que chaque tenant puisse nommer ses rôles librement, il a fallu une migration qui repère les doublons, retire l’index unique sur le nom et le remplace par un index unique sur le couple tenant et nom. Décider dès la création de chaque entité si elle appartient à un tenant, et donc à quel niveau elle doit être unique, évite ce genre de migration sur des données existantes.