Moderniser une plateforme B2B React et Node.js
Développeur référent sur une plateforme collaborative B2B en production depuis 2021, j’ai modernisé progressivement son code sans interrompre les évolutions : retrait de Redux, composants passés aux hooks, pages plus rapides et droits revus.
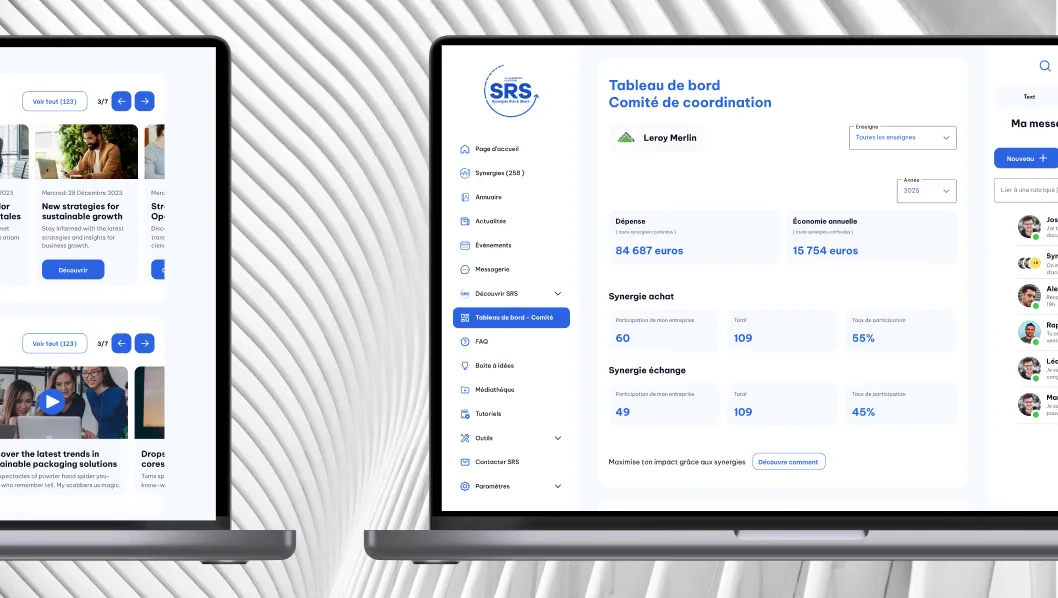
SRS fait travailler ensemble les entreprises partenaires d’un grand groupe français de la distribution. Elles y partagent des documents, organisent des événements, lancent des sondages, échangent par messagerie et suivent les économies réalisées en commun. Chez Ikomobi, j’étais le développeur référent du projet, de la correction d’anomalies aux nouvelles fonctionnalités, en passant par la modernisation progressive du code. J’y ai développé de bout en bout le suivi des économies réalisées, les tutoriels, les notifications planifiées et le tableau de bord du comité de coordination, et fait évoluer le reste de la plateforme, dont la messagerie interne. L’objectif était de faire évoluer la plateforme sans interrompre son fonctionnement ni ralentir les évolutions attendues.
D’où partait la plateforme ?
En service depuis 2021, la plateforme repose sur trois applications. Une API Node.js / Express stocke les données structurées dans MySQL et les contenus plus souples dans MongoDB. Un back-office React est utilisé par les administrateurs, tandis qu’une application React installable (PWA) est destinée aux membres des entreprises.
Comme beaucoup d’applications en production depuis plusieurs années, le code avait évolué au fil des équipes et des besoins. Certaines modifications demandaient donc plus de temps qu’elles n’auraient dû. Plusieurs facteurs l’expliquaient :
- des parties du code écrites à des périodes différentes et selon des approches différentes ;
- Redux, choix courant au moment de sa mise en place, devenu plus lourd que nécessaire pour l’usage qu’en faisait l’application ;
- des composants React encore écrits sous forme de classes ;
- des anomalies à traiter au fil de l’eau ;
- une bibliothèque de documents particulièrement lente à charger.
Il fallait pourtant continuer à livrer les nouvelles fonctionnalités attendues, sans que les utilisateurs perçoivent de rupture dans leur utilisation de la plateforme.
Comment moderniser sans arrêter les évolutions ?
Une refonte complète aurait gelé le produit pendant plusieurs mois. Le lead dev, le chef de projet et le client ont donc retenu l’approche inverse : améliorer progressivement le code existant et profiter de chaque évolution pour assainir la partie concernée.
Restait à intégrer ce travail au planning existant. J’ai proposé au chef de projet et au client, qui ont validé cette approche, de consacrer une partie du temps de TMA (tierce maintenance applicative) à la qualité du code et à l’amélioration des temps de chargement, en plus des corrections et des demandes fonctionnelles.
Cette organisation a permis de faire avancer la modernisation sans ouvrir de projet dédié ni mettre les évolutions produit de côté. Ce temps a notamment servi aux montées de version majeures, validées avec le lead dev : React 19 pour le back-office et la PWA, Express 5 et Node.js 22 pour l’API.
Chaque changement passait ensuite par un environnement de staging, où une recette manuelle permettait de vérifier les parcours concernés avant toute mise en production.
Les priorités restaient fixées par le chef de projet et le client. Je mettais en œuvre les améliorations retenues et j’en proposais lorsque cela répondait à leurs objectifs. La modernisation avançait ainsi au même rythme que les nouvelles fonctionnalités.
Pourquoi retirer Redux, et par quoi le remplacer ?
Redux reste pertinent lorsqu’une application doit gérer un état complexe partagé entre de nombreux écrans. Ce n’était plus vraiment le cas ici. Le store servait principalement à conserver des copies de données provenant de l’API.
Ces copies pouvaient facilement se désynchroniser : une donnée modifiée sur un écran n’était pas forcément rafraîchie sur un autre et pouvait même être remplacée par une version plus ancienne. Chaque évolution impliquait par ailleurs de passer par des actions, des reducers et des sélecteurs. Maintenir Redux devenait ainsi plus coûteux que de simplifier son fonctionnement.
Redux a donc été entièrement retiré. L’état réellement partagé passe désormais par quelques contextes React ciblés, chacun avec une responsabilité précise :
- l’authentification et l’utilisateur connecté ;
- la navigation ;
- les notifications et messages affichés à l’utilisateur ;
- les documents et dossiers de la bibliothèque, ainsi que les groupes.
Le reste demeure dans l’état local des composants. Chaque écran recharge désormais les données dont il a besoin, ce qui a supprimé les problèmes liés aux données périmées ou écrasées. Le fond du problème était là. Les données de l’API sont un état serveur, que le serveur peut modifier à tout moment, et leur copie dans un store devient une seconde vérité à tenir à jour. Recharger par écran suffisait sur cette plateforme. Quand plusieurs écrans partagent les mêmes données, une librairie de cache serveur comme TanStack Query prend le relais.
Dans le même temps, les composants en classes ont été migrés vers des composants fonctionnels utilisant des hooks. Le code est ainsi devenu plus homogène et plus simple à maintenir.
Comment accélérer les pages sans toucher à l’architecture ?
J’ai ensuite repris chaque page en analysant ses appels réseau. Le cas le plus courant était celui d’appels indépendants lancés les uns après les autres : leurs temps d’attente s’additionnaient alors inutilement.
Comme ces appels étaient indépendants, je les ai lancés en parallèle avec Promise.all. Le temps d’attente ne dépend alors plus de la somme des trois appels, mais principalement du plus long.
// Simplified example
// Before: three sequential calls, wait times add up
const group = await api.get(`/groups/${id}`);
const events = await api.get(`/groups/${id}/events`);
const documents = await api.get(`/groups/${id}/documents`);

// After: independent calls start at the same time
const [group, events, documents] = await Promise.all([
  api.get(`/groups/${id}`),
  api.get(`/groups/${id}/events`),
  api.get(`/groups/${id}/documents`),
]);
L’autre piste portait sur l’API elle-même : j’ai réduit les données renvoyées, avec des endpoints dédiés à chaque écran qui ne transmettent que ce que la page affiche.
La bibliothèque de documents, qui était la plus lente à charger, a été l’un des premiers endroits concernés. L’ensemble des pages a ensuite bénéficié de cette approche.
Comment gérer les permissions ?
La plateforme accueille plusieurs entreprises, dont les utilisateurs n’ont pas tous les mêmes responsabilités. Les permissions combinent donc deux niveaux.
Les rôles globaux, comme celui d’administrateur de la plateforme, s’appliquent partout. Le rôle de pilote, que j’ai développé, est quant à lui attribué groupe par groupe. Il permet de gérer un groupe sans donner accès à l’administration de l’ensemble de la plateforme.
L’API assure ces contrôles au moyen de middlewares Express placés devant les routes concernées. La vérification est donc effectuée côté serveur, et non uniquement dans l’interface, afin que les permissions ne puissent pas être contournées en modifiant simplement le comportement du client.
Pour le rôle de pilote, le middleware lit l’identifiant du groupe dans l’URL et vérifie en base que l’utilisateur pilote bien ce groupe, sans se fier à ce qu’envoie le client. Un administrateur de la plateforme passe dans tous les cas. En voici le principe, réécrit de façon générique :
// Simplified example: group-scoped role, or a global admin role
async function requireGroupPilot(req, res, next) {
  const user = req.auth // set by the authentication middleware
  if (!user) return res.status(401).end() // not authenticated

  const isAdmin = ['admin', 'superAdmin'].includes(user.role)
  const isPilot = await UserGroup.exists({ userId: user.id, groupId: req.params.id, pilot: true })
  if (!isAdmin && !isPilot) return res.status(403).end() // authenticated, not allowed

  next()
}

router.patch('/groups/:id', requireGroupPilot, updateGroup)
Les deux codes d’erreur ne disent pas la même chose. Un 401 signifie que la requête n’est pas authentifiée, et le client peut réessayer après connexion. Un 403 signifie que l’utilisateur est bien connecté mais n’a pas le droit d’agir, et se reconnecter n’y changera rien.
La DXP multi-tenants sur laquelle j’ai aussi travaillé reprend ce même principe de séparation des responsabilités, mais à une échelle plus large.
Que ferais-je différemment ?
Je soignerais davantage la communication dès le départ. Au début, j’hésitais parfois à relancer ou à solliciter quelqu’un pour un point qui me semblait secondaire.
J’ai depuis appris à faire clarifier les sujets dès qu’un point est flou, quitte à relancer plusieurs fois si nécessaire. Une question posée suffisamment tôt coûte généralement moins cher qu’un malentendu découvert au moment de la livraison.